読みもの
ノイズを足す道を、逆にたどる
文章の指示から、見たこともない絵を描き出すAIがあります。その一部は、「ノイズから絵を作る」という、不思議な仕組みを使っています。ただの砂嵐のような画面から、どうして絵が現れるのでしょうか。その数式の核だけを、小さな点の模型で見てみます。
絵を、少しずつ壊していく
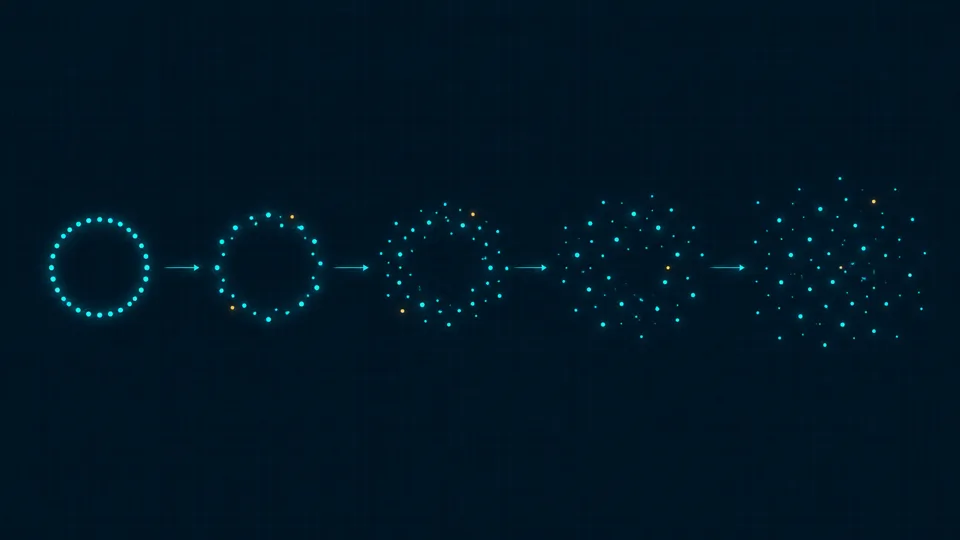
輪の形に並んだ40個の点を、元の絵だと思ってください。これに、ノイズ(標準正規分布の乱数)を少しずつ混ぜていくと、輪は崩れ、やがて、ただの点の雲になります。ステップ t での点は、元の点に √ᾱ、ノイズに √(1−ᾱ) の割合を掛けて足したものです。t=5 では元の信号の係数が 0.805、ノイズの係数が 0.594。t=10 では 0.406 と 0.914 で、元の形はほとんど分かりません。
壊す手順は式で決まっている。だから、壊した絵と、混ぜたノイズが分かれば、元に戻せる。
ノイズが分かれば、元に戻る
式を逆にすれば、ノイズ入りの点とノイズから、元の点が求まります。ノイズを正確に知っていれば、どのステップからでも、元の点に完全に戻ります。つまり、ノイズを当てることと、元に戻すことは、同じことです。拡散モデルでは、ニューラルネットが、ノイズ入りの絵から、混ぜられたノイズを予測する役を担います。
予測が外れると、ずれる
もちろん、ノイズの予測は、完璧ではありません。予測に、標準正規乱数の 0.1 倍の誤差を加えて外れを模擬すると、戻した点と元の点のずれは、t=3 で 0.055、t=5 で 0.097、t=10 で 0.297 でした。ノイズが多いステップほど、同じ誤差でも、ずれが大きくなります。
模型と、本物の違い
この章では、ノイズを私たちが知っています。本物のモデルは、学習のときは、元の絵とノイズを使って、「ノイズ入りの絵と時刻から、ノイズを当てる」練習をします。作るときは、ランダムなノイズから出発し、学習した逆向きの遷移を繰り返して、新しい絵を段階的に作ります。特定の元の絵を復元するわけではありません。この模型は、そこまでは再現していません。
「ノイズを当てる」という、うまい問題設定
絵を作るという、漠然とした難しい問題を、「ノイズ入りの絵から、混ぜられたノイズを当てる」という、はっきりした問題に変えているのが、この方式の工夫です。正解(混ぜたノイズ)は、学習のときには必ず分かっているので、損失を計算でき、これまで見てきた学習の方法が、そのまま使えます。
一度に作らず、少しずつ作る
作るときは、一度にノイズから絵を作るのではなく、少しずつ、ノイズを減らしていきます。1回の修正は小さくても、それを多数回繰り返すことで、ランダムな雲から、形が現れてきます。小さな歩みの積み重ねで、遠くへ行く。この考え方は、坂を下る学習とも、どこか似ています。
手を動かして確かめる
輪の形に並んだ40個の点に、ノイズ(標準正規分布の乱数)を足していくと、輪は崩れて、やがて、ただの点の雲になります。拡散モデルは、この逆向き、つまり、ノイズを少しずつ取り除く計算を学習して、ノイズから形を作ります。ここでは、各ステップの点を式で直接計算し(比較しやすいよう、同じ乱数を使います)、ノイズを足す側と、取り除く側の、数式の部分だけを、手で動かして見ます。
t を動かして、輪が崩れる様子を見てください。次に、ノイズ推定の誤差の係数 δ を上げて、戻した点(琥珀色)のずれを見ます。
計算を順に追う
1. 元の点に、ノイズを混ぜる
元の点 x₀ に、ノイズ ε を、一定の割合で混ぜたものが、ステップ t の点です。この例では、10ステップで、混ぜ方を、少しずつノイズ寄りにします(β は 0.02 から 0.3 まで、自作の設定)。t=5 では、元の信号の係数が 0.805、ノイズの係数が 0.594 です。t=10 では、0.406 と 0.914 になり、元の形はほぼ分かりません。
x_t = √ᾱ_t · x₀ + √(1−ᾱ_t) · ε
ᾱ_5 = 0.6474、ᾱ_10 = 0.1652
2. ノイズが分かれば、元に戻せる
式を逆にすれば、x_t とノイズ ε から、元の x₀ が求まります。δ=0(ノイズを正しく知っている)なら、どのステップからでも、元の点と完全に一致します。つまり、ノイズを正しく当てることが、元に戻すことと同じです。拡散モデルでは、ニューラルネットが、ノイズ入りの点から、ノイズ ε を予測する役目を担います。
x₀ = ( x_t − √(1−ᾱ_t) · ε ) / √ᾱ_t
3. 予測が外れると、ステップが進むほど、ずれが大きい
ノイズの推定に、標準正規乱数の δ 倍(δ=0.1)の誤差を加えて外れを模擬したとき、戻した点と元の点の距離は、t=3 で 0.055、t=5 で 0.097、t=10 で 0.297 です(40点の二乗平均平方根)。ずれは、√(1−ᾱ)/√ᾱ に比例して、ノイズが多いほど、同じ誤差でも、ずれが大きくなります。実際のモデルは、学習した逆向きの遷移を繰り返して、段階的に作ります。この模型は、その生成の過程までは再現していません。
δ = 0.1:t=3 → 0.055、t=5 → 0.097、t=10 → 0.297
δ = 0.3:t=3 → 0.164、t=5 → 0.292、t=10 → 0.890
4. この章の模型と、本物の違い
この章では、ノイズ ε を、私たちが知っています。本物のモデルは、学習のときは、元の絵とノイズを使って、「ノイズ入りの絵と時刻 t から、ノイズを当てる」練習をします。作るときは、ランダムなノイズから出発して、新しい絵を段階的に作ります(特定の元の絵を復元するのではありません)。また、実際は高次元のデータを扱い、ステップ数やノイズ量の設定も、方式によって違います。画像を作るAIの方式は、ほかにも、2つのネットワークを競わせる方式(GAN。次の章で小さな模型を動かします)など、いろいろあります。
思い出しメモ 「標準正規分布」は、平均0・分散1の、釣鐘型の乱数の分布です。ここでは、ノイズの種類を指す言葉として使っています。