読みもの
偽札づくりと、見破る側の競争
「本物そっくりのものを作る」ことを、機械に学習させるには、何を計算させればよいのでしょうか。2014年に投稿された論文は、この問いを、2人の競争に見立てました。論文の説明では、偽物を作る側は、偽札をつくって、気づかれずに使おうとする人たちです。見分ける側は、その偽札を見破ろうとする警察です。
競うと、双方が上手くなる
偽札づくりは、はじめは下手で、すぐに見破られます。警察は、見破りながら、本物と偽物の違いを覚えていきます。すると、偽札づくりは、見破られた点を直します。この繰り返しで、偽物が、本物と見分けられないところまで来る。論文は、この競争が、双方を上達させる、という見立てを述べています。これを、2つの数式(偽物を作る関数と、本物か偽物かを見分ける関数)に置き換えたものが、敵対的生成ネットワーク、GAN です。
1つの損失を下げるのではなく、2つの損失が、引っぱり合う。
2つの損失の引っぱり合い
これまでの章では、1つの損失を決め、坂を下って小さくしてきました。GAN では、見分ける側は、本物に高く、偽物に低い確率を付けるほど、うまくいきます。作る側は、見分ける側が、偽物に高い確率を付けるほど、うまくいきます。1つの式を、片方は大きく、片方は小さくしようとするのです。論文の理論では、どんな関数でも表せる理想の状態で、偽物の分布が本物と一致し、見分ける側が、どこでも 1/2 と答える点が、解として示されます。つまり、見分けがつかなくなった状態です。
この理想の状態では、見分ける側の損失(本物と偽物を1つずつ見たときの値)は、2 ln 2=1.386 になります。この章の模型では、1歩目にこの値が表示され、序盤に 0.6 前後まで下がったあと、1.39 前後に戻ります。ただし、この値は、見分けがつかないことを示すだけで、偽物が本物と一致した証拠ではありません。山の幅が合っていない設定でも、1.39 前後になるからです。実際の学習では、作る側の目的を、少しだけ置き換える工夫が、論文に示されています。序盤は、見分ける側が、偽物を自信をもって退けるので、元の式のままでは、作る側に、十分な傾きが伝わらないからです。
学習の進め方で、結果が変わる
ただし、理想どおりには進みません。この章の小さな模型で、見分ける側の学習率を、作る側と同じ 0.1 に下げると、偽物の山の幅は、本物の約2割まで細くなり(1000歩)、そのあと本物の1.6倍ほどまで広がり(2000歩)、また細くなる、という大きな揺れになりました。論文は、作る側を、見分ける側を更新せずに進めすぎると、多くの乱数を同じ出力に潰してしまうことがある、と述べています。山が1つしかないこの模型の揺れは、それとは別の現象です。画像などを作る GAN で、作る側が一部のものしか作らなくなる現象は、のちの文献で「モード崩壊」と呼ばれることがあります。学習率などの設定が、結果を大きく左右するのです。
画像を作る、別の道との比べ方
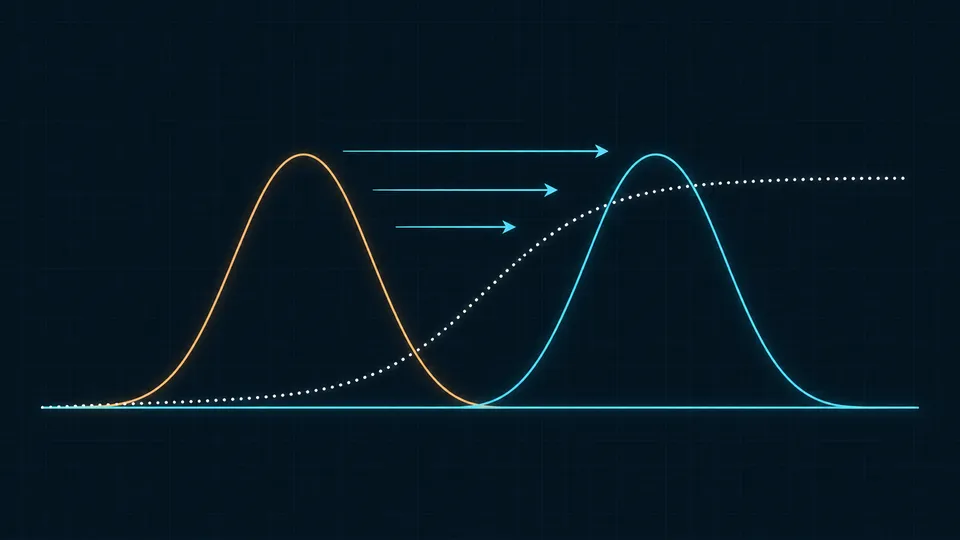
前の章の拡散モデルは、1つの網が、「ノイズを当てる」練習をします。GAN は、2つの網が競います。どちらが優れている、という話は、ここではしません。ただ、同じ「本物らしいものを作る」という目標に、学習のさせ方が違う道がある、ということは、覚えておく価値があります。小さな模型で、橙の山が水色の山に近づいていく様子を、自分の手で確かめてみてください。
手を動かして確かめる
数直線の上に、本物のデータがあります。平均が4、ばらつき(標準偏差)が1.25の山の形です(自作の設定)。偽物を作る側 G は、乱数 z に a を掛けて b を足し、偽物の数を作ります。最初は a=1、b=0 なので、偽物は平均0の山で、本物とは離れています。もう一方の見分ける側 D は、ある数が、本物のデータ側から来た確率を、推定して出します。この2つを交互に学習させると、偽物の山が本物に近づいていくのか、見てみます。これは、敵対的生成ネットワーク(GAN)の、ごく小さな模型です。
「100歩」を押して、橙の山(偽物)が水色の山(本物)に近づく様子を見てください。そのあと、D の学習率を 0.1 まで下げ、「最初から」を押して、「1000歩」を何回か押すと、山の幅はどう動くでしょうか(細い山は、上が枠の外に出ます)。
計算を順に追う
1. 偽物を作る側と、見分ける側
G は、標準正規分布の乱数 z から、偽物 x=a·z+b を作ります。D は、入力 x が、本物のデータ側から来た確率の推定値を、σ(w₁u+w₂u²+c) で出します(σ は、0から1の間に収めるシグモイド関数です)。u は x を 4 で割った値で、値の大きさをそろえて、学習が荒れないようにする前処理です。u² の項を入れたのは、山の位置だけでなく、幅の違いも見分けられるようにするためです。最初は w₁、w₂、c がすべて0で、D はどんな x にも 0.5 を返します。
G(z) = a·z + b 最初は a = 1、b = 0
D(x) = σ(w₁·u + w₂·u² + c)、u = x / 4 最初は w₁ = w₂ = c = 0
2. 2人のゲームの式と、最適な見分け役
D は、本物に高い確率、偽物に低い確率を付けたい。G は、D に、偽物へ高い確率を付けさせたい。論文は、これを、1つの式 V(D, G) を、D は大きく、G は小さくしようとするゲーム(ミニマックスゲーム)として書きました(E は期待値で、x は本物のデータ、z は標準正規分布の乱数にわたって取ります。log は自然対数 ln です)。D が、どの x にも 0.5 と答えるとき、本物と偽物を1つずつ見た D の損失は、−ln 0.5 − ln 0.5=2 ln 2=1.386 です(1歩目に表示される値です)。G を固定したとき、最適な D は、本物の山 p_data と偽物の山 p_g から決まる形で、論文に示されています。最初の偽物(平均0・標準偏差1)に対しては、x=4 で 0.9996、x=2 で 0.6217、x=0 で 0.0048 になります。偽物が本物と同じ山になれば、最適な D は、どこでも 1/2 です。
V(D, G) = E_{x∼p_data}[ log D(x) ] + E_{z∼N(0,1)}[ log(1 − D(G(z))) ]
min_G max_D V(D, G)
D*(x) = p_data(x) / ( p_data(x) + p_g(x) )
最初の偽物:D*(4) = 0.9996、D*(2) = 0.6217、D*(0) = 0.0048
本物と偽物が同じ山:D*(x) = 1/2
3. 交互に1歩ずつ、学習する
1歩ごとに、まず D を、本物64個・偽物64個で更新し、続いて G を、新しい64個の乱数で更新します。G の目的は、論文にあるとおり、log(1 − D(G(z))) を小さくする形ではなく、log D(G(z)) を大きくする形に置き換えています(序盤に D が偽物を自信をもって退けると、元の形では、G に十分な傾きが伝わらないためです)。学習率は、D が 1.0、G が 0.1 です(論文の実験と同じ、D を1回更新するごとに G を1回更新する形(k=1)です。D の学習率を大きくして、G の動きに追いつけるようにしています)。乱数の種1の、最初の100歩は、次のとおりです。偽物の平均 b が、0 から、本物の 4 へ向かい、100歩ほどで届きます。
歩数 1:b = 0.006、|a| = 1.004
歩数 10:b = 0.209、|a| = 1.063
歩数 30:b = 1.297、|a| = 1.263
歩数 60:b = 3.303、|a| = 1.065
歩数 100:b = 4.262、|a| = 0.878
4. 長く続けると、揺れながら落ち着く
平均 b は、100歩ほどで 4 に届き、そのあと、ばらつき |a| が、行き過ぎては戻りながら、本物の 1.25 に近づきます。乱数の種を100通り変えて、その平均を見ると、500歩では |a| が 1.54 と広がりすぎ、1000歩で 1.02 と縮み、3000歩で 1.24 に落ち着きます。b は、3000歩で 4.00 です。このとき、D の出力は、x=4 で、100通りの平均が約 0.50 です(種ごとには 0.4〜0.6 程度に散らばります)。D の損失は、序盤の10〜30歩で 0.6 前後まで下がったあと、1歩あたり 1.39 前後(理論値 2 ln 2=1.386 に近い値)に戻ります。ただし、損失と D の出力は、D が見分けられていないことを示すだけで、偽物が本物に合った証拠にはなりません(D の学習率を 0.1 にした場合も、山の幅が合っていないのに、損失は 1.39 前後です)。偽物が本物に近いかどうかは、b と |a| で確かめます。ただし、細かな数字は、ブラウザなどの計算環境の違いで、小数第2位が変わることがあります。
学習率 D 1.0・G 0.1(本物:b = 4、|a| = 1.25。いずれも100通りの平均)
500歩 :b 3.93、|a| 1.54、D(4) 0.48
1000歩:b 4.06、|a| 1.02、D(4) 0.50
3000歩:b 4.00、|a| 1.24、D(4) 0.50(b と |a| の、種による差=標準偏差は、どちらも約 0.03)
3000歩までの終わり300歩の、D の損失の平均:1.39 前後、正解率 50% 前後
5. D の学習率を下げると、大きく揺れる
D の学習率を、G と同じ 0.1 に下げます。偽物の山の幅 |a| は、500歩で 0.40、1000歩で 0.27(100通りすべてで 0.3 より小さい)と、本物の約2割まで細くなります。ところが、そのあとは広がり、2000歩では 2.04 と、本物より広くなり、3000歩で 0.57 に戻ります。20000歩まで続けても、1.1 前後で揺れ続けます(20通りでの確認)。1000歩は、たまたま谷の底に近い時点で、細くなって止まるわけではありません。「1000歩」を何回か押して、確かめてみてください。なぜ揺れが大きくなるのかは、ここでは調べていません。論文は、G を、D を更新せずに進めすぎると、多くの z を同じ x に潰してしまう場合がある、と述べています(「Helvetica scenario」と呼んでいます)。山が1つしかない、この模型の揺れは、これとは別の現象です。なお、D の学習率を 2.0 まで大きくしても、よくなるとは限りません。3000歩でも b は 3.67 と、4 に合いませんでした。
学習率 D 0.1・G 0.1(100通りの平均)
500歩 :b 4.05、|a| 0.40
1000歩:b 4.21、|a| 0.27(100通りすべてで |a| < 0.3)
2000歩:b 3.71、|a| 2.04
3000歩:b 4.16、|a| 0.57
20000歩:|a| 約1.1(20通り)
学習率 D 2.0・G 0.1、3000歩(100通りの平均):b 3.67、|a| 1.45
6. この模型と、本物の違い
この章では、G は直線の式、D は2次式の入ったごく小さな関数で、データは1次元の数です。画像生成などで使われる GAN は、高次元のデータを、多層のニューラルネットで扱います。論文の理論(偽物が本物と一致し、D がどこでも 1/2 になる)は、どんな関数でも表せる、という理想の状態での話です。実際の有限の網では、この一致は保証されません。この章で見たように、学習率などの設定が、結果を大きく左右します。前の章の拡散モデルは、1つの網がノイズを当てる練習をしましたが、GAN は、2つの網が競う形です。どちらがよい、という比べ方は、ここではしません。
思い出しメモ 「標準偏差」は、データのばらつきの目安で、山の幅を表します。「シグモイド」は、どんな値も0から1の間に収める関数で、確率を出すときに使います。