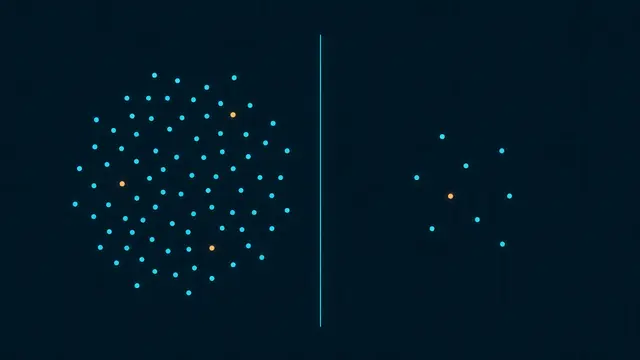
データの偏りは、答えの偏りになる
AIは、与えられたデータから学びます。では、そのデータが偏っていたら、どうなるでしょうか。数値1つで、2つのグループを分ける、ごく単純な問題で、その仕組みを確かめてみます。
しきい値は、データが決める
A群の数値は0のあたり、B群は2のあたりにばらつきます(自作の例)。分けるための境目(しきい値)は、学習データでの間違いが最小になる点に決めます。A群もB群も50点ずつあれば、この100点では、しきい値は 0.62 でした。2つのグループは左右対称の設定なので、本来の境目はもう少し真ん中寄りのはずですが、100点という少ないデータのばらつきで、少しずれました。
片方が増えると、境目が寄る
学習データのA群を70%、90%と増やすと、しきい値は 1.60、1.72 へと、B群のほうへ動きます。数の多いA群を間違えないほうが、全体の間違いが減るからです。AとBが同数の別のデータで測ると、Aを正しく答える割合は 74.3% → 94.1% → 96.1% と上がり、Bを正しく答える割合は 91.9% → 65.8% → 60.4% と下がりました。
全体の正解率だけを見ていると、少数のグループでの失敗が、見えなくなる。
見落とさないために
学習データと同じ割合のデータで測れば、全体の正解率は高く見えます。しかし、数の少ないB群での成績は悪くなっています。偏りに気づくには、グループごとに成績を分けて見る必要があります。
偏りは、集め方から入る
偏りは、誰に聞いたか、どこで集めたか、いつ集めたかといった、データ集めの段階から入ってきます。直す方法には、データを足す、割合を調整する、グループごとに評価する、などがありますが、偏りが完全になくなるとは限りません。実際のAIでも、特定のグループでの成績の差として現れることが知られています。
偏りに気づくための問い
データの偏りに、気づくには、いくつかの問いが役立ちます。このデータは、誰から、どこで、いつ集めたものか。集められなかった人や場面はないか。グループごとに、成績は、そろっているか。これらは、AIに限らず、データを使うすべての場面で、有効な問いです。
悪意がなくても起きる
偏りは、誰かが意図的に作るものとは限りません。集めやすいデータを集めた結果、自然に偏ることが、よくあります。だからこそ、「悪意がないから大丈夫」とは言えず、意識的な点検が必要になります。この章の例のように、数値1つの単純な設定でも、偏りが、境目を動かす様子を、数で確かめられます。