読みもの
自由度に「罰」をつけて、暴れを抑える
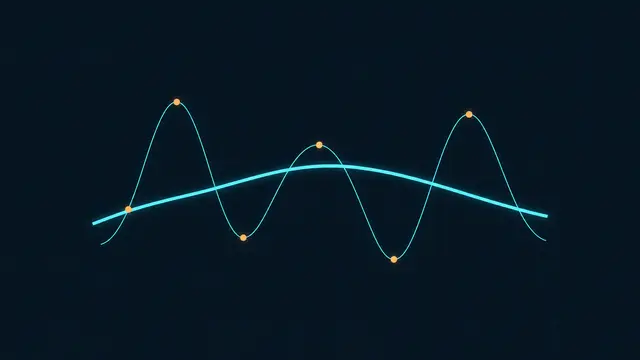
前の章で、次数5の曲線は、6点を全部通るかわりに、点と点の間で暴れることを見ました。データを増やせないとき、この暴れを抑える方法はあるでしょうか。一つの答えが、「係数を大きくすると、罰がつく」という条件を足すことです。
誤差に、罰を足す
曲線が暴れるのは、係数が大きくなるためです。そこで、「誤差の二乗和」に、「係数(定数項を除く)の二乗和 × λ」を足した合計を、小さくします。λ が罰の強さで、大きいほど、係数を小さく保つ力が強くなります。この方法は、リッジ回帰と呼ばれます。
罰の強さ λ は、「点にどれだけ合わせるか」と「どれだけおとなしくするか」の、天秤。
λ を上げると、おとなしくなる
λ=0 では、学習に使った点の誤差は 0.000、使っていない点の誤差は 1.120 でした。λ=0.1 では 0.127 と 0.213、λ=1 では 0.150 と 0.173。学習に使った点の誤差は増えますが、曲線が暴れなくなり、使っていない点の誤差は、まず大きく下がります。
強すぎても、よくない
ただし、λ=10 では、使っていない点の誤差が 0.173 から 0.204 に、むしろ増えました。罰が強すぎると、曲線が単純になりすぎて、本来の傾向まで表せなくなるのです。λ は、大きすぎても小さすぎてもよくない、調整つまみです。
どの λ を選ぶか
λ は、学習に使わなかったデータでの誤差を見て選びます。この例では λ=1 が最良でした。ただし、選ぶのに使った5点での最小誤差は、選んだあとの本当の性能ではありません。本当の性能は、さらに別のデータで確かめる必要があります。
「単純なほうがよい」という原則
正則化の背景には、「同じくらいよく合うなら、単純なモデルのほうが、新しいデータに強い」という考え方があります。この章の多項式では、入力の尺度を固定したまま係数を抑えると、曲線の変動が抑えられる効果が期待できます。これは、同じ程度に説明できるなら、簡潔な説明を優先する、という方針の表れです。
万能ではない
ただし、罰を強くしすぎると、単純になりすぎて、本来の傾向まで失います。また、どんな問題でも、単純なほうが良いとは限りません。「単純さを好む」のは、あくまで、データが少なく、ノイズがあるときの、安全策の一つです。選び方を、データで確かめる姿勢が、ここでも要ります。
手を動かして確かめる
前の章の、次数5の曲線(学習に使った6点を、すべて通る曲線)を、もう一度使います。曲線が暴れるのは、係数が大きくなるためです。そこで、「係数を大きくすると罰がつく」という条件を足して、罰の強さ λ を変えてみます。
λ のスライダーを動かして、曲線の形と、2つの誤差の変化を見てください。
計算を順に追う
1. 誤差に、係数の大きさの罰を足す
これまでは、学習に使った点との誤差だけを小さくしました。ここでは、「誤差の二乗和」に、「係数(定数項を除く)の二乗和 × λ」を足した合計を、小さくします。λ が大きいほど、係数を小さく保つ力が強くなります。この方法は、リッジ回帰と呼ばれます(ニューラルネットの学習では、重み減衰という名前で、似た働きをする方法が使われます。最適化の方法によっては、罰則を足す方法と重み減衰が一致しないこともあるため、ここでは考え方だけを見ます)。
最小にするもの = Σ (曲線の値 − 実際の値)² + λ × (係数の二乗和)
2. λ を上げると、曲線がおとなしくなる
λ=0 では、学習に使った点の誤差は 0.000 で、使っていない点の誤差は 1.120 でした。λ=0.1 では 0.127 と 0.213、λ=1 では 0.150 と 0.173、λ=10 では 0.167 と 0.204 です。表の誤差は、点ごとの二乗誤差の平均です(最小にする目的関数は、二乗和+罰則です)。λ を上げると、学習に使った点の誤差は増えますが、曲線が暴れなくなり、使っていない点の誤差は、まず大きく下がります。
λ 学習の点 使っていない点
0 0.000 1.120
0.001 0.007 0.815
0.01 0.075 0.340
0.1 0.127 0.213
1 0.150 0.173
10 0.167 0.204
3. 強すぎても、よくない
λ=10 では、使っていない点の誤差が 0.173 から 0.204 に増えました。罰が強すぎると、曲線が単純になりすぎて、本来の傾向まで表せなくなります。λ は、大きすぎても小さすぎてもよくない、調整つまみです。
4. λ は、学習に使わないデータで選ぶ
どの λ がよいかは、学習に使わなかったデータでの誤差を見て選びます。この例では、λ=1 が、使っていない点の誤差が最も小さくなりました。この選び方も、前の章の「学習に使わないデータで確かめる」と同じ考え方です。ただし、λ を選ぶのに使った5点は、いわば検証用で、そこでの最小誤差 0.173 は、選んだあとの本当の性能ではありません。本当の性能は、さらに別のデータ(テスト用)で確かめる必要があります。
思い出しメモ 「正則化」は、モデルが複雑になりすぎないように、制約や罰を加えることの総称です。罰の形によって、いろいろな方法があります。