第1章 情報社会の問題解決
人工知能(AI)の仕組みと付き合い方(機械学習・生成AI・偏り)
迷惑メールの自動の仕分け、予測変換、文章や絵を作る生成AI。身の周りのAIは、たくさんのデータから学んで動いています。このページでは、AIとは何か、機械学習の流れ(学習データ→学習→モデル→予測)、教師あり学習、ディープラーニングと生成AIの仕組み、間違い・偏り、著作権・個人情報との関係、上手な使い方を、図と動く部品で確かめます。
説明
1. AIは、人の「見分ける・予測する」をまねする技術
スマホで文字を打つと、次に打ちそうな言葉が出てきます。写真アプリは、写っている人ごとに写真を分けてくれます。メールの迷惑メールは、自動で別のフォルダに入ります。どれも、人なら「見て・読んで・考えて」していたことです。
このように、見分ける・聞き取る・予測する・文や絵を作るといった人の知的な働きの一部を、コンピュータで行う技術を人工知能(AI:Artificial Intelligence)と呼びます。日本の法律(AI推進法 第2条)でも、人の「認知、推論及び判断」に関わる知的な能力をコンピュータで代わりに行う技術、という意味で定められています。
身の周りのAI
AI=人の知的な働き(見分ける・予測する・作る)の一部をコンピュータで行う技術。
2. ルールを人が書くか、データから学ぶか
迷惑メールを見分けるプログラムを作るとき、2つのやり方があります。Aは、人が「リンクが3個以上なら迷惑」のようなルールを考えて、プログラムに書くやり方です。分かりやすい反面、ルールを考えるのは人なので、人が気づかない特ちょうは使えず、手口が変わるたびに書き直しが必要です。
Bは、「これは迷惑」「これは普通」と正解の札を付けたメールをたくさん集め、コンピュータに見分け方そのものを見つけさせるやり方です。これを機械学習と呼びます。今のAIの多くは、この機械学習で作られています。
機械学習は、たくさんの例(データ)から、見分け方や予測の仕方をコンピュータが見つけるしくみ。
3. 機械学習の流れ:学習データ → 学習 → モデル → 予測
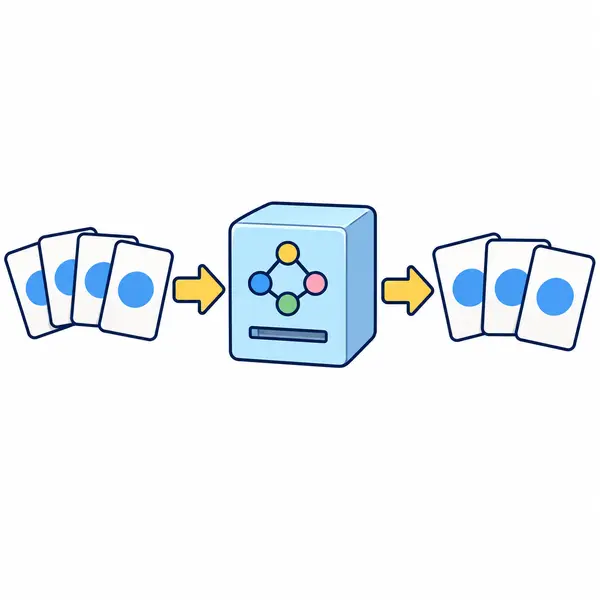
機械学習は、2つの段階に分かれます。① 学習:学ぶために集めた例のデータを学習データ(訓練データ)と呼びます。コンピュータは学習データを使って、見分け方を少しずつ調整します。でき上がった見分け方のかたまりを学習済みモデル(単に「モデル」とも)と呼びます。
② 予測:答えの分からない新しいデータを学習済みモデルに入れると、「迷惑メールらしい」のような予測が出ます。学習には時間がかかりますが、一度モデルができれば、予測は何回でも素早くできます。予測が当たるかどうかは、学習データの量と質で大きく変わります。
学習データで学んで「学習済みモデル」を作り、そのモデルで新しいデータを予測する。
4. 教師あり学習:正解の札から学ぶ(分類と回帰)
「迷惑」「普通」のように、学習データに正解の札(ラベル)を付けて学ばせる方法を教師あり学習と呼びます。教師あり学習には、主に2つの使い方があります。
- 分類:どの種類かを当てる(迷惑メールかどうか、写真の動物は何か)。
- 回帰:どのくらいの数かを当てる(気温から飲み物の売れる数を予測する)。第4章で学ぶ回帰直線も、その1つです。
ほかに、札を付けずに、似たデータ同士をグループに分ける教師なし学習(例:買い物の記録から、似た好みの客をまとめる)や、試してみて「うまくいったら得点」を元に、よい行動を学ぶ強化学習(例:ゲームやロボットの動かし方)もあります。
札があるか、ないか(図解の絵)
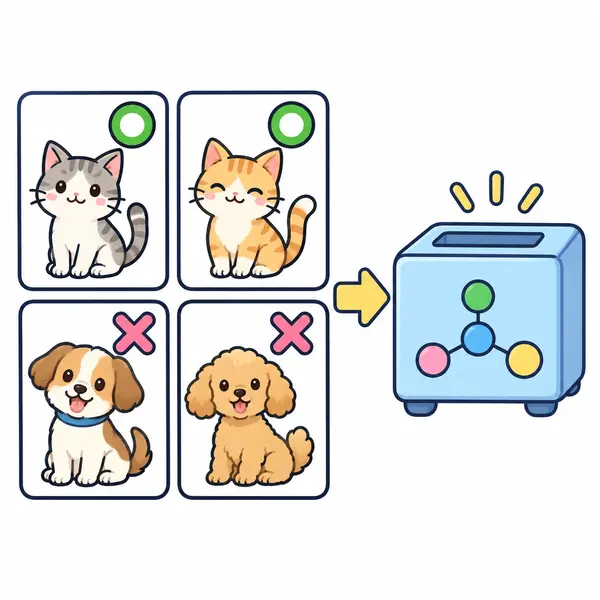
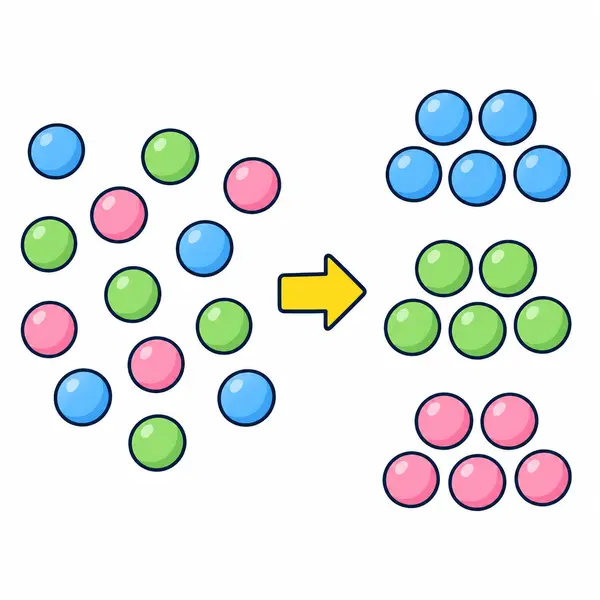
教師あり学習=正解の札つきの例で学ぶ。分類は「種類」、回帰は「数」を当てる。
5. 「学ぶ」とは、間違えたら少し直すこと
コンピュータは、どうやって見分け方を見つけるのでしょうか。一番単純な例で見てみます。メールを「リンクの数」と「あおる言葉の数」の2つの数で表し、グラフの点にします。●が普通のメール、▲が迷惑メールです。
はじめは、てきとうな線を1本引き、線の右上を「迷惑」と予測することにします。学習データの点を1つずつ調べ、予測が間違っていたら、その点が正しい側に入る向きへ、線を少し動かします。これをくり返すと、1本の線で分けられる並び方なら、やがて全部の点を正しく分ける線ができます。この「間違いを見て少しずつ直す」が、機械学習の基本の考え方です。下の「さわってみよう」で、1手ずつ試せます。
予測と正解を比べ、ずれが小さくなるように、少しずつ調整する。これが学習。
6. ディープラーニング:線をたくさん重ねる
写真を見て「ねこ」「いぬ」を見分けるには、1本の線では足りません。そこで、説明5の「線を1本引くしくみ」のような小さな計算を、網のようにたくさんつないで何層も重ねたものを使います。人の脳の神経細胞のつながりを手本にした形なので、ニューラルネットワークと呼びます。
層を深く重ねたニューラルネットワークで学ぶ方法をディープラーニング(深層学習)と呼びます。画素の明るさから、輪郭・もよう・形と、だんだん複雑な特ちょうを自分で見つけられるので、画像や声の認識、翻訳などの精度が大きく上がりました。その代わり、とても多くの学習データと計算が必要で、なぜその答えになったのかを人が説明しにくい、という面もあります。
ディープラーニング=何層も重ねたニューラルネットワークで学ぶ方法。精度は高いが、理由の説明は難しい。
7. 生成AI:次に来そうなものを選んで作る
文章や画像を新しく作るAIを生成AIと呼びます。AIへの指示や質問の文をプロンプトと呼びます。文章を作る生成AIは、ばく大な量の文章から「ある言葉の次には、どんな言葉が来やすいか」を学んでいます。そして、入力された文に続く言葉を、確からしさを元に1つ選んでは足す、をくり返して文を作ります。
このため、生成AIの文は自然で最もらしいのですが、内容が事実かどうかを確かめて書いているわけではありません。存在しない本や、間違った数字を、自信がありそうに書くことがあります。これをハルシネーションと呼びます。同じ質問でも、聞くたびに答えが変わることもあります。
生成AIの仕組みと間違い(図解の絵)
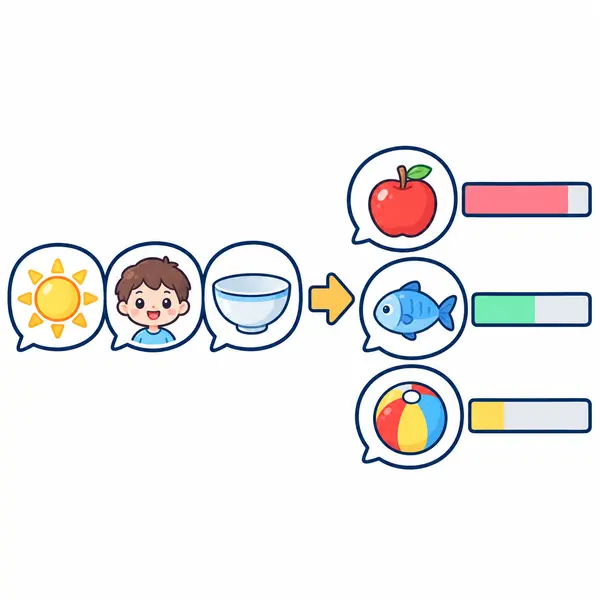
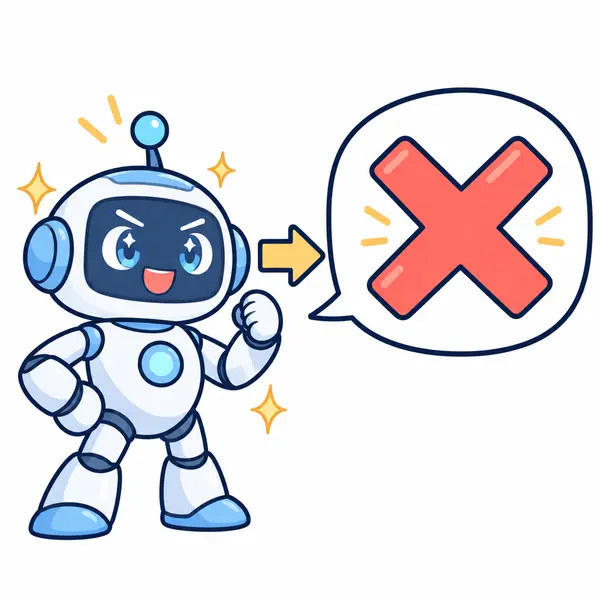
生成AIは「最もらしい」ものを作る。「正しい」とは限らないので、必ず確かめる。
8. 学習データが偏ると、予測も偏る
AIは、学習データにないことは苦手です。学習データに偏りがあると、予測も偏ります。このようなデータや予測のかたよりをバイアスと呼びます。例えば、迷惑メールの例として「とても目立つもの」だけを集めて学ばせると、図の右のように線が右上に寄り、境目に近い迷惑メールを「普通」と予測してしまいます。
現実でも、ある年れいや地域の人のデータが少ないと、その人たちへの判定の精度が下がる、といった問題が起こります。AIの答えは公平に見えても、元のデータのかたよりや、学んだ時点の古さを受けついでいることがあります。いろいろな場合のデータを集めること、学習に使っていないデータで確かめること、人が結果を点検することが大切です。学習データのくせまで覚え込み、学習データではよく当たるのに新しいデータでは外れる過学習も、確かめ用のデータで見つけられます。
偏り取その直し方(図解の絵)

AIの予測のかたよりは、学習データの偏りから生まれる。学習に使っていないデータで確かめる。
9. AIと著作権・個人情報
著作権:AIと著作権は、2つの段階に分けて考えます(文化庁「AIと著作権に関する考え方について」)。開発・学習の段階では、著作権法 第30条の4により、作品の表現を楽しむ(享受する)ことが目的ではない利用(AIに学ばせるための情報解析など)は、必要と認められる範囲で、原則として著作権者の許可なしでできます。ただし、特定の作品の表現をそのまま出力させるためなど、楽しむ目的も合わせもつ場合は当てはまりません。著作権者の利益を不当に害する場合も除かれます。生成・利用の段階では、普通の著作物と同じく、AIで作ったものが既存の作品に似ていて(類似性)、しかもそれを元にしている(依拠性)と、著作権の侵害になりえます。実際にどうなるかは、一つ一つの場合によって判断されます。
個人情報:生成AIに入力した内容は、サービスによってはAIの学習に使われることがあります。また、生成AIの答えに、不正確な個人情報が混ざることもあります(個人情報保護委員会の注意喚起)。自分や友だちの名前・住所・写真などは入力しないこと、使う前に利用規約やプライバシーポリシーを確かめることが大切です。
気を付けること(図解の絵)

楽しむ目的でない学習のための利用は第30条の4、作ったものを使うときは普通の著作権と同じ。個人情報はAIに入れない。
10. 上手に使う:確かめる・自分で考える・最後は人が決める
AIは、速い・たくさん処理できる・つかれないのが得意です。一方で、事実かどうかの確認、相手の気持ちを考えること、責任をもって決めることは、人の役目です。生成AIの答えは「下書き」と考え、本や公式の資料・先生などで確かめてから使いましょう。宿題やレポートでは、学校のルールに従い、AIを使ったことを書き添えます。
AIやロボットが広がると、人の仕事の中身も変わります。決まった作業はAIが手伝い、人はAIの結果を確かめる・判断する・新しいことを考える仕事にうつっていきます。AIを動かすデータを集める、AIの間違いを点検する、といった新しい仕事も生まれています。
AIと人の役割(図解の絵)
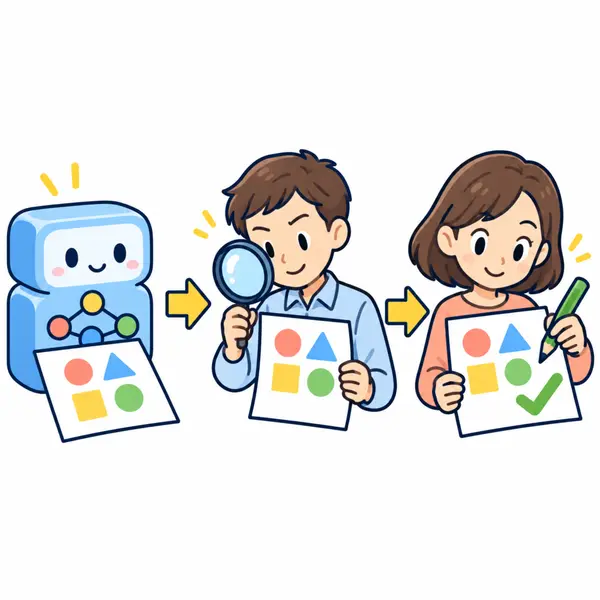
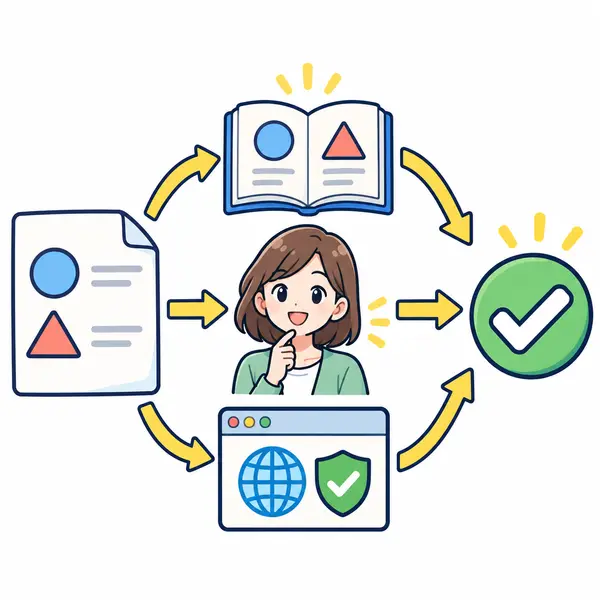
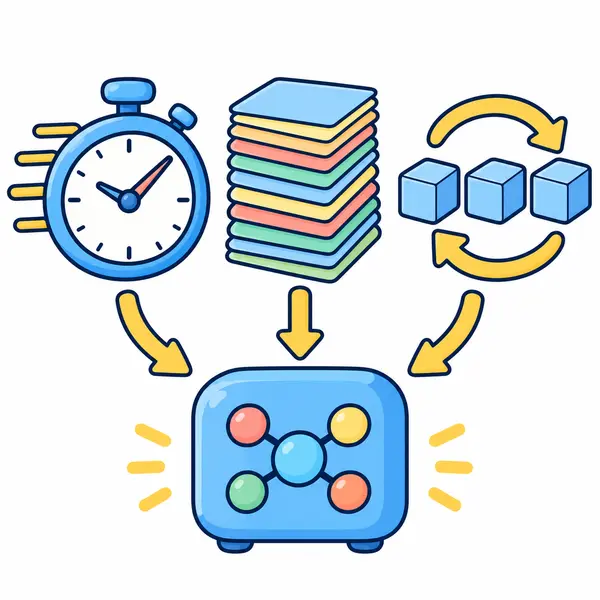
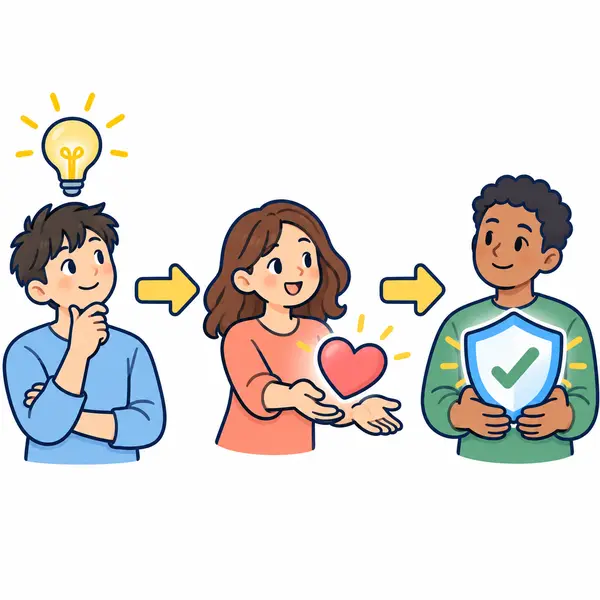
AIの答えは下書き。確かめる・自分で考える・最後に決めるのは人。
ひとことで言うと機械学習を使うAIは、データから学んで予測する。正しいとは限らないので、確かめて使う。
例題
例題1 野菜を見分けるAIを作る流れ
園芸部の A さんは、畑で取れた野菜の写真を撮ると、なす・ピーマン・トマトのどれかを答えるAIを、教師あり学習で作りたいと考えています。(1) 学習データとして何を用意すればよいですか。(2) 作ったAIを使うとき、何を入力すると、何が出てきますか。
- 教師あり学習では、正解の札(ラベル)がついた例が必要です。
- (1) 野菜の写真に「なす」「ピーマン」「トマト」の札を付けたものを、それぞれたくさん用意します。これが学習データです。明るさや向き、大きさが違う写真も混ぜると、見分けやすくなります。
- 学習データで学習させると、見分け方の固まり(学習済みモデル)ができます。
- (2) 使うときは、札のない新しい写真を入力します。モデルは「ピーマン」のような予測を出します。予測は間違うこともあるので、学習に使っていない写真で、どのくらい当たるかを確かめておきます。
例題2 偏った学習データ
図書委員会では、去年1年間の貸出の記録から「この本を借りた人には、次にこの本がおすすめ」と予測するAIを作りました。ところが、去年の記録は9割以上が3年生のものでした。このAIを1年生に使うと、どんなことが起こりそうですか。また、どうすればよいですか。
- AIは学習データから学ぶので、学習データのかたよりが、予測のかたよりになります。
- 記録のほとんどが3年生のものなので、おすすめは3年生の好み(受験の参考書など)に寄りやすく、1年生の好みに合わない本ばかりが出るおそれがあります。
- 対策:1年生・2年生の記録も増やしてから学び直す、学年ごとに分けて学ばせる、1年生の記録で当たり方を確かめる、などが考えられます。
- さらに、AIのおすすめをそのまま使わず、図書委員が点検したり、違う分野の本もしょうかいしたりすると、偏りをおさえられます。
練習
さわってみよう
機械学習:点を分ける線を1手ずつ学ぶ
迷惑メール(▲)と普通のメール(●)を、「リンクの数」と「あおる言葉の数」で点にしました。「1手進める」を押すと、点線の丸の点を1つ調べ、予測が間違っていれば線を動かします。「1周まとめて」で、全部の点を1回ずつ調べます。まず「偏りのないデータ」で学ばせ、白ぬきの確かめ用の点がいくつ正しく予測できるかを見ます。次に「偏ったデータ」に切りかえて学ばせる前に、確かめ用の点の正しい数がどうなるか予想してください。グラフをタップすると、点を足して学び直すこともできます。
偏りのないデータで学んだ線は、確かめ用の10個をすべて正しく予測できます。目立つ迷惑メールだけで学んだ線は右上に寄り、境目に近い迷惑メール3個を「普通」と予測してしまいます(10個中7個)。学習データが全部正しく分けられていても、学習に使っていないデータでは外れることがあります。どんなデータで学んだかが、AIの予測を決めます。
やってみよう(共通テスト形式)
このサイトで作った問題です(過去の試験問題ではありません)。
情報部の A さんと B さんは、学校の問い合わせ用のメールアドレスに届くメールを、迷惑メールとそれ以外に自動で分けるしくみを、機械学習で作ってみることにした。次は、2人と先生の会話である。
A さん:まず、これまでに届いたメールを集めて、ア をつけた学習データを作ります。
先生:そうだね。集めたメールを全部学習に使わずに、一部は残しておくといいよ。
B さん:どうしてですか。
先生:学習に使ったメールで正しく分けられても、それだけでは十分とはいえないからだよ。
A さん:去年の迷惑メールの例は、リンクがたくさん並んだ、だれが見ても分かるものばかりでした。
先生:それだと、少し困ったことが起こるかもしれないね。それから、問い合わせへの返信の文を生成AIで下書きするなら、使い方にも気をつけよう。
ちょっと寄り道:豆知識・こぼれ話
試験に出るとはかぎりませんが、知っていると情報がもっと面白くなる話です。
「人工知能」という名前は、1955年の計画書から
artificial intelligence(人工知能)という言葉は、1955年8月に、アメリカの研究者マッカーシー、ミンスキー、ロチェスター、シャノンの4人が書いた研究計画書で初めて使われたとされています。「学習など知能の働きは、機械でまねできるくらい正確に書き表せるはずだ」として、翌1956年の夏にダートマス大学で、10人ほどで2か月の研究会を開こうという提案でした。この研究会が、人工知能という研究分野の出発点とされています。4人のうちのシャノンは、情報の量をビットで測る考え方を作った人です。
参考:J. McCarthy, M. L. Minsky, N. Rochester, C. E. Shannon, “A Proposal for the Dartmouth Summer Research Project on Artificial Intelligence”(1955年), AI Magazine 27巻4号(2006年)に再録
チューリングの「50年後」の予言
1950年、イギリスの数学者アラン・チューリングは論文「計算する機械と知能」で、「機械は考えることができるか」という問いを、あるまねっこゲームに置きかえました。質問する人が、文字のやり取りだけで、相手が人間か機械かを当てるゲームです。チューリングは、およそ50年後には、普通の質問者が5分間やり取りしても、正しく見分けられる見込みが70%以下になるほどの機械ができるだろうと予想しました。このゲームは、のちに「チューリング・テスト」と呼ばれるようになります。
参考:A. M. Turing, “Computing Machinery and Intelligence”, Mind 59巻, 1950年
1966年の会話プログラムに、人は心を開いた
1966年、アメリカの MIT のワイゼンバウムは、文字で会話するプログラム ELIZA(イライザ)を発表しました。相手の文の中のキーワードなどを手がかりに、あらかじめ用意した規則で、質問や相づちなどの返事を作るしくみで、意味を理解しているわけではありません。それでも、話し相手になった人の中には、本気で悩みを打ち明ける人がいました。ワイゼンバウムによると、プログラムを作るところを何か月も見ていた秘書でさえ、少し話すと「部屋から出ていってほしい」と頼んだそうです。この経験から、ワイゼンバウムは、機械に人間らしさを感じてしまう心の危うさを訴え続けました。
参考:J. Weizenbaum, “ELIZA”, Communications of the ACM 9巻1号, 1966年;J. Weizenbaum, Computer Power and Human Reason, 1976年
わからなかったら、ここへもどる
- 著作権(権利の中身・保護期間・例外)
- 個人情報・プライバシー・肖像権
- 中学数学「座標」(2つの量を点で表す)準備中
先生・おうちの方へ
つまずきやすい所:①「AIは人と同じように意味を理解して考えている」と思いこむ(実際はデータの特ちょうから予測している)。②学習と予測(推論)の2段階が区別できない。③学習データで当たれば十分だと思う(学習に使っていないデータで確かめる理由)。④生成AIの文が自然なので、内容も正しいと思う。
授業で使うとき:「さわってみよう」で、偏ったデータに切りかえる前に、確かめ用の点の正しい数を予想させると、バイアスが「データから生まれる」ことが実感できます。グラフをタップして境目近くの迷惑メールを足し、学び直させると、データの集め方で直せることも確かめられます。部品の仕組みは、一番単純なニューラルネットワーク(パーセプトロン)の学習則です。
共通テストとのつながり:AIそのものの出題はまだ少ないですが、データの活用(第4問)と、情報モラル・著作権・個人情報(第1問・第2問)の観点で、生成AIを場面にした出題が考えられます。学習データ・テスト用データ・偏り、の3点を押さえておくと会話文を読み解きやすくなります。
正確さについて:著作権の説明は、文化庁「AIと著作権に関する考え方について」(令和6年3月)の、開発・学習段階と生成・利用段階に分ける整理に従っています。第30条の4のただし書き(著作権者の利益を不当に害する場合)に当たるかどうかや、類似性・依拠性の判断は、個別の事案ごとに行われます。生成AIと個人情報は、個人情報保護委員会「生成AIサービスの利用に関する注意喚起等」(令和5年6月2日)の一般の利用者への留意点に沿っています。生成AIの確率の図の数値は説明用の例です。
根拠:学習指導要領解説 情報編は、(1)ア(ウ) で「人工知能やロボットなどで利用される情報技術の発展が社会の利便性を高め…る反面…」「人工知能などの発達により人に求められる仕事の内容が変化していくこと」を、イ(ウ) で「人工知能やロボットなどの情報技術の補助を受けたときに人に求められる仕事がどのように変わるか考える力」を扱うとしています。
学習指導要領:情報Ⅰ (1)ア(ウ)・イ(ウ) / 参考:高等学校学習指導要領(平成30年告示)解説 情報編 情報Ⅰ (1)ア(ウ)・イ(ウ)、文部科学省「高等学校情報科『情報Ⅰ』教員研修用教材」第1章 学習5 情報技術の発展(人工知能、ディープラーニング)、人工知能関連技術の研究開発及び活用の推進に関する法律(令和7年法律第53号)第2条・第3条第4項(e-Gov法令検索 https://laws.e-gov.go.jp/law/507AC0000000053)、著作権法 第30条の4(e-Gov法令検索 https://laws.e-gov.go.jp/law/345AC0000000048)、文化庁「AIと著作権について」(文化審議会著作権分科会法制度小委員会「AIと著作権に関する考え方について」令和6年3月) https://www.bunka.go.jp/seisaku/chosakuken/aiandcopyright.html、個人情報保護委員会「生成AIサービスの利用に関する注意喚起等」(令和5年6月2日) https://www.ppc.go.jp/news/careful_information/230602_AI_utilize_alert